系列第 5 篇 · 预计阅读 12 分钟
任何一个做过 RAG 的人,迟早都会撞上这堵墙。
你辛辛苦苦搭好了检索管线——BM25 分词、向量化 embedding、倒排索引——用户问了一个问题,系统哗啦啦拉回来几十篇文档,你心想“答案肯定在里面”,然后一股脑塞进 LLM 的 prompt。
结果 LLM 答错了。你去排查,发现正确的答案确实在拉回来的那堆文档里——排在第十几个位置。
问题不在 LLM。问题在于排名顺序。BM25 比的是关键词重叠,向量搜索看的是语义相似度。但“用词像”跟“真的回答了问题”之间,隔着一个 LLM 都跨不过去的鸿沟。
TypeSafe 在 CLERC 法律检索数据集上跑了个实验,把这个问题量化得非常清楚。
问题:BM25 能召回,但排不准
实验设置是这样的:3,565 份美国法院判词作为语料库,从中挑 40 个作为查询。每个查询用 BM25 扫描全部 3,565 份文档,拉出关键词重叠最多的前 30 个候选。
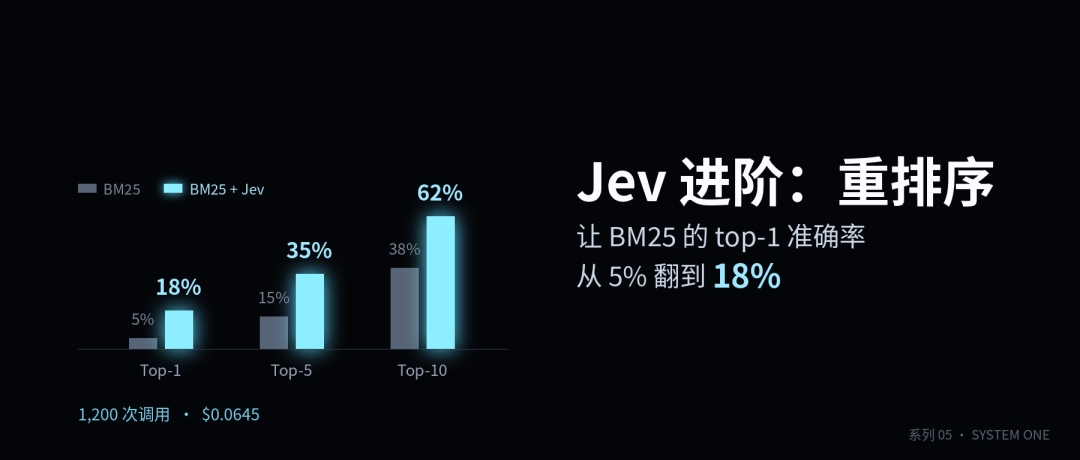
结果呢?正确答案出现在这 30 个候选里的概率是 100%——BM25 的召回没问题。但正确答案排在第一名的概率只有 5%。
5%。也就是说如果你直接把 BM25 的 top-1 塞给 LLM 让它基于此回答,95% 的情况下你给的是错误的材料。
这就是 RAG 的核心矛盾:粗筛方法速度够快、召回够全,但它根本不知道哪个候选“回答了问题”。它只知道哪个候选“用了差不多的词”。
但你也不能不用 BM25。没有它,你就得让一个更精确的模型去扫 3,565 份文档——这对任何模型来说都是不可接受的延迟和成本。
设计决策:把搜索拆成两步
所以正确的思路不是“找个更好的搜索替代 BM25”,而是把搜索拆成两个阶段,各司其职。
第一步,fast search(粗筛):BM25 或向量搜索跑全量语料,从几千份文档筛选出几十个候选。这一步的唯一职责是召回——保证正确答案在短名单里。BM25 干这个活绰绰有余。
第二步,re-rank(精排):用一个更聪明但更贵的模型,逐一审视短名单里的每个候选,判断它是否真正回答了查询。这一步的职责是精度——把正确答案从短名单的中后排推到最前面。
关键洞察在于:精排模型只需要看 30 个候选,不是 3,565 个。所以即使它比 BM25 慢一百倍,总成本仍然可控——因为它只跑在短名单上。
那为什么不用 LLM 做精排? 当然可以用。但你需要自己定义一套评分标准,然后把 30 个候选分别塞进 prompt,祈祷 LLM 对每个候选用的是同一把尺子。而且 LLM 是随机采样——同一个 query-candidate pair 问两次,可能拿到不同的分数。最后你还要解析它的文本输出,提取一个数字。所有这些开销——延迟、成本、不一致、解析——就为了拿到“一个分数”。
Jev 的方案简单得多。一个 Noul 问题,精心定义 true 和 false 的精确边界:
is_cited_source = Noul(
instructions=(
“The query excerpt comes from a US federal court opinion and was written “
“immediately around a citation to a precedent; the citation itself has been “
“removed. Could the candidate passage be from that cited precedent — does it “
“establish the specific legal proposition the query excerpt invokes at its “
“citation point?”
),
criteria=NoulCriteria(
true=(
“The candidate passage states or establishes the specific rule, standard, “
“holding, or fact pattern that the query excerpt attributes to its removed “
“citation.”
),
false=(
“The candidate passage is merely on a similar topic or doctrine; it does not “
“supply the specific proposition the query excerpt relies on.”
),
),
)
重点看 criteria。true 不是笼统的“相关”,而是精确到“陈述或确立了查询所引用的具体法律规则”。false 也不是简单的“不相关”,而是“只是主题相似,没有提供查询所依赖的具体论断”。
这个边界的精度决定了整个重排序的质量。写得太窄,真正相关的候选会被误判为 false。写得太宽,无关候选会混进来稀释排名。
调用逻辑极简——对每个候选做一次请求,拿到 noul 值,排序:
nouls = {candidate: ask_typesafe(query, candidate) for candidate in shortlist}
reranked = sorted(shortlist, key=lambda c: nouls[c], reverse=True)
30 次 Jev 请求,排序完成。和调用一次 LLM 推理相比,这 30 次请求的总成本可能更低。
数据验证:1,200 次调用,六美分
TypeSafe 在 40 个查询上跑了完整的两步流程——40 × 30 = 1,200 次 Jev 调用。
重排序前(纯 BM25):
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
重排序后(BM25 + Jev):
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
Top-1 翻了 3.6 倍,Top-10 从不到四成拉到超过六成。如果你把重排后的前 10 个候选都放进 prompt,超过六成的情况下正确答案在其中——这个概率,你的 RAG 系统已经可以用起来了。
成本明细: 1,200 次调用,消耗 1,536,002 个输入 token 和 25,200 个输出 token。按 Jev 的定价(输入 $0.042/百万 token,输出免费),总花费 $0.0645。
六美分,做完 1,200 次精排判断。
延伸:生产环境怎么优化
官方 cookbook 为了清晰,每个候选只问了一个问题。但 Jev 的一
次 system_one 请求可以同时问任意多个问题——你可以把相关性、权威性、时效性、是否包含对立观点等多个判断维度打包在一起。
这意味着你不需要 30 次请求——你可以把相关性判断 + 权威性判断 + 时效性判断全部放在一次请求里,甚至可以一次请求同时评估多个候选(详见官方文档的 Speculative Fan-Out 模式 https://docs.typesafe.ai/patterns/fan-out)。请求数不是 30 次,是 1 次。
但原理不变:BM25 粗筛,Jev 精排,代码排序。两步走,两步分工明确。
这个模式最厉害的地方不在于“Jev 比 BM25 准”。而在于它让你不用在“全量精确搜索”和“粗糙快速搜索”之间二选一。 你两者都要——BM25 的速度覆盖全量,Jev 的精度聚焦短名单。两个加起来,才是完整的搜索。
下一篇:重排序解决的是“一堆候选里哪个最相关”。下一篇我们换一个场景——你只有一份文档,218 行,用户问了一个问题,你要精确地告诉他答案在哪一行。而且一次请求完成。